在存储系统的交付验收中,可能遇到这样一种情况:厂商产品的各项指标已经达标,用户却发现实际业务跑不起来。
这与存储系统所面对的业务场景有很大关系,用户过去采购存储设备,通常会关注带宽、IOPS、时延和容量等指标。曙光信息产业(北京)有限公司分布式存储产品部产品经理康玉琢谈到,在大模型训练和推理场景下,数据访问方式发生了明显变化,仅凭传统指标,已经很难判断一套存储系统能否真正满足业务需求。
与此同时,我们也看到,市场上不同厂商对AI存储的定义、测试条件和场景假设也存在差异。有的产品强调带宽,有的侧重海量小文件处理能力,即使都叫AI存储,实际擅长的业务场景也可能完全不同。
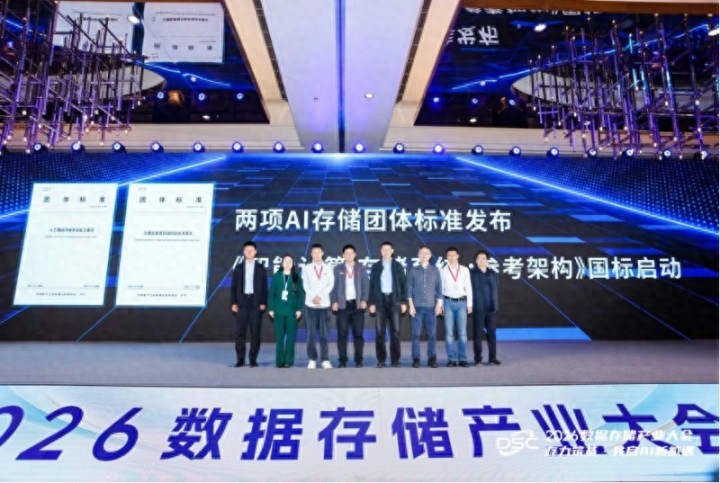
在2026数据存储产业大会上,中科曙光与多家单位共同启动新的国家标准建设工作,并发布《人工智能存储系统能力要求》和《大模型推理存储系统技术要求》两项已落地的团体标准。
AI存储怎么评,传统指标不适用了?
在大模型训练过程中,几十甚至上百个计算节点可能同时访问存储系统。即使一套存储设备在单客户端测试中表现出很高的带宽,也不代表它在大规模并发访问下能够保持同样的性能。康玉琢认为,评价AI存储需要重点关注四个方面。
第一,关注大规模、多客户端并发下的性能表现。相比单节点、单客户端的峰值性能,更需要考察存储系统在大规模并发访问时的实际表现。
第二,元数据处理能力。AI业务涉及大量图片、文本和标注文件,文件数量很容易达到亿级规模,文件创建、删除、遍历和查询的压力都非常大。传统存储面对亿级元数据时,容易出现卡顿、时延上升等问题。
第三,不同AI场景下的能力适配。训练场景更看重高聚合带宽和高并发下的稳定性,推理场景更关注低时延,数据集预处理场景更重视文件导入、导出的效率,归档场景则更关注容量和成本。一套存储系统很难在所有场景下都做到最优,因此需要判断产品主要适配哪类AI业务,是否符合自身的实际需求,不能单纯追求各项性能指标的最高值。
第四,业务层面的稳定性和数据可靠性。大规模训练任务通常运行周期较长,一旦中途出现存储性能抖动或I/O时延毛刺,就可能造成任务中断或回滚。因此需要重点考察持续高负载下的I/O时延波动、数据完整性校验,以及任务中断后的业务恢复效率。传统存储评价体系在可靠性方面,则更多强调故障发生后的数据完整性、容错能力和后续处理。
由于缺少统一的存储架构评价标准,AI存储在实际应用中面临不少问题。此次发布的两项团体标准,主要针对其中三类技术痛点提出了相应的能力要求。
首先是建立了五维AI存储能力架构,从AI加速、扩展性、兼容性、可靠性和安全性五个方面,对AI存储的能力要求进行了系统化界定,解决了过去评价维度较为碎片化的问题。
其次是针对加速器直通存储、零拷贝、多加速器并发和资源隔离等技术,提出了明确的能力要求,着力解决AI业务中数据路径拷贝次数多、算力开销大的问题。
第三是区分了训练和推理场景的不同需求,专门针对推理场景定义了KV Cache组件、知识库、记忆库等特有模块的技术要求,进一步完善了大模型推理存储的技术规范。

两项标准,分别解决什么问题?
此次发布的两项团体标准中,《人工智能存储系统能力要求》面向AI存储系统的整体能力,《大模型推理存储系统技术要求》则针对大模型推理场景中的特有需求,进一步明确相关技术要求。
正品配资平台对于《人工智能存储系统能力要求》,除了建立统一的能力评价体系,标准发布后也将对存储产品的研发产生影响。
在大模型训练场景中,产品研发将更加关注分层模型加载、数据集快照回滚、数据预热、大规模并发访问以及静默数据损坏防护等能力。存储系统的评价也将更加重视PB级至EB级的线性扩展能力,以及多计算节点并发访问下的实际业务稳定性,减少对单客户端峰值性能的依赖。
不同规模的大模型,对存储系统的要求也存在差异。康玉琢解释,这些差异主要体现在存储容量、性能以及支撑能力等方面,可以进行相应的分层或分级。虽然上层模型的实现方式各有特点,但到了底层数据交互环节,仍然存在一些共同需求。
《大模型推理存储系统技术要求》则主要针对推理场景特有的技术需求。
康玉琢解释,训练与推理具有不同的I/O模型和存储能力要求,很难通过一项通用的AI存储标准,完整涵盖训练、推理以及其他业务场景的全部技术需求。特别是近一两年,推理相关技术发展迅速,业务需求也在不断变化,因此此次专门针对推理制定了一项技术标准。
在大模型推理场景中,标准明确了KV Cache跨节点卸载与共享、前缀缓存,以及加速器直通知识库、记忆库等能力与接口规范。通过这些技术要求,将推动存储系统从传统的文件、对象数据承载,进一步支持推理中间缓存以及知识、记忆数据,降低显存压力,提升长上下文和高并发推理的整体效果。
从具体内容来看,《人工智能存储系统能力要求》主要为AI存储系统建立共同的能力要求,《大模型推理存储系统技术要求》则进一步规范推理过程中KV Cache、知识库和记忆库等特有模块的技术能力及接口要求。
从选型到验收,标准怎么落下来?
随着AI技术的快速发展,业务需求发生了很大变化,许多问题对存储行业来说仍然是新课题。各家厂商都在探索解决方案,产品和技术路线呈现出百花齐放的局面。在这一阶段,加强AI存储标准建设十分必要。
首先是用户侧需求迭代快,对AI存储的认知也存在差异。相比传统虚拟化业务,AI业务对存储的要求发生了较大变化,过去的选型思路已经难以直接沿用。面对海量小文件、高并发元数据访问,以及大带宽、高I/O混合负载等需求,用户往往缺少明确的存储能力评价依据,容易在产品选型时出现偏差。
其次是产业侧的产品评价口径尚未统一。不同厂商对AI存储指标的定义、测试条件和场景假设存在差异。同样是AI存储产品,有的侧重带宽性能,有的则更关注小文件处理能力。这种差异给用户和第三方评测机构带来了困难,很难对不同产品进行横向比较。
第三是国内AI基础设施规模化建设的实际需求。随着智算中心、大模型平台等项目大批量建设,供需双方在需求沟通、项目验收和系统对接等环节,都需要相对统一的技术要求和评价依据。如果缺少共同标准,各方容易因理解不同产生分歧,增加沟通和协调成本。
“推动AI存储标准建设,也是希望将现有的产业实践沉淀为行业共识,减少不同技术要求之间的冲突。”康玉琢谈到。
据了解,此次两项团体标准由中电标协下设的存储专业委员会统筹推进,中科曙光作为专委会轮值主席单位,牵头编制了其中一项,并深度参与另一项的编制工作。
元股证券:ygzq.hk
标准编制完成只是第一步,如何推动标准在产业中落地同样关键。从产品工作的角度来看,后续还需要做好几个方面的工作。
首先是加强标准的宣贯和解读,缩小各方的认知差异。对于刚刚发布的标准,很多用户和集成商可能还不了解具体内容,因此需要通过更加通俗的方式,讲清楚标准能够解决哪些实际问题。
其次是将标准要求融入产品研发体系。厂商需要把标准中的能力基线和测试要求纳入产品规划、迭代和出厂测试流程,让研发团队按照标准开展自测,确保产品能力符合相关要求,避免标准停留在产品宣传层面。
第三是建立配套的测试验证手段。标准虽然规定了测试方法和前提条件,但实际执行还需要相应的测试工具、测试数据集和公共测试环境。因此,需要第三方机构或产业联合测试平台依据标准开展测试,为标准落地提供可验证的手段。
此外,还需要建立标准的更新迭代机制。AI技术发展速度很快,大模型规模和业务形态持续变化。仅在2026年内,大模型训练和推理的方法、框架等就已经发生了不少变化。面对这样的技术发展速度,无论是团体标准还是国家标准,发布后都需要考虑如何及时跟进市场需求和技术演进,建立相应的更新机制。
最终两项标准可以帮助用户更准确地梳理业务需求,厂商也能够据此设计产品和方案。尤其在测试验证和交付验收环节,双方有了共同的评价依据,减少因指标理解不同而产生的分歧实盘券商配资,让存储系统的能力要求与实际业务需求更好地对应起来。
据央视新闻消息,央视记者当地时间8日获悉,美国前总统拜登的儿子亨特·拜登在接受媒体采访时表示,拜登的前列腺癌持续恶化,癌
2026-08-10
当百年历史文化街区遇上国际冰雪盛会,厚重文脉与青春激情碰撞出别样火花。6月29日,参加“蓄势・见证・倾城——全国主流媒体
2026-08-10
在第二届世界人形机器人运动会上,一台机器人因掩面奔跑的姿态神似演员而迅速走红。这背后既有赛场上的“名场面”,也有技术层面
2026-08-23据新华社华盛顿8月8日电 美国副总统万斯8日表示厦门股票配资信息服务平台,美国同伊朗正在对话,美伊冲突仍处于“博弈中段”
2026-08-10
大皖新闻讯 10月24日长春股票杠杆,来自巢湖、舒城两地多所幼儿园的师生及家长走进庐江县万山镇奇迹农庄,开展秋季社会实践
2026-10-31